Kandidát na tokenizers 1.0 kóduje text podle měření autorů třikrát až třicetkrát rychleji
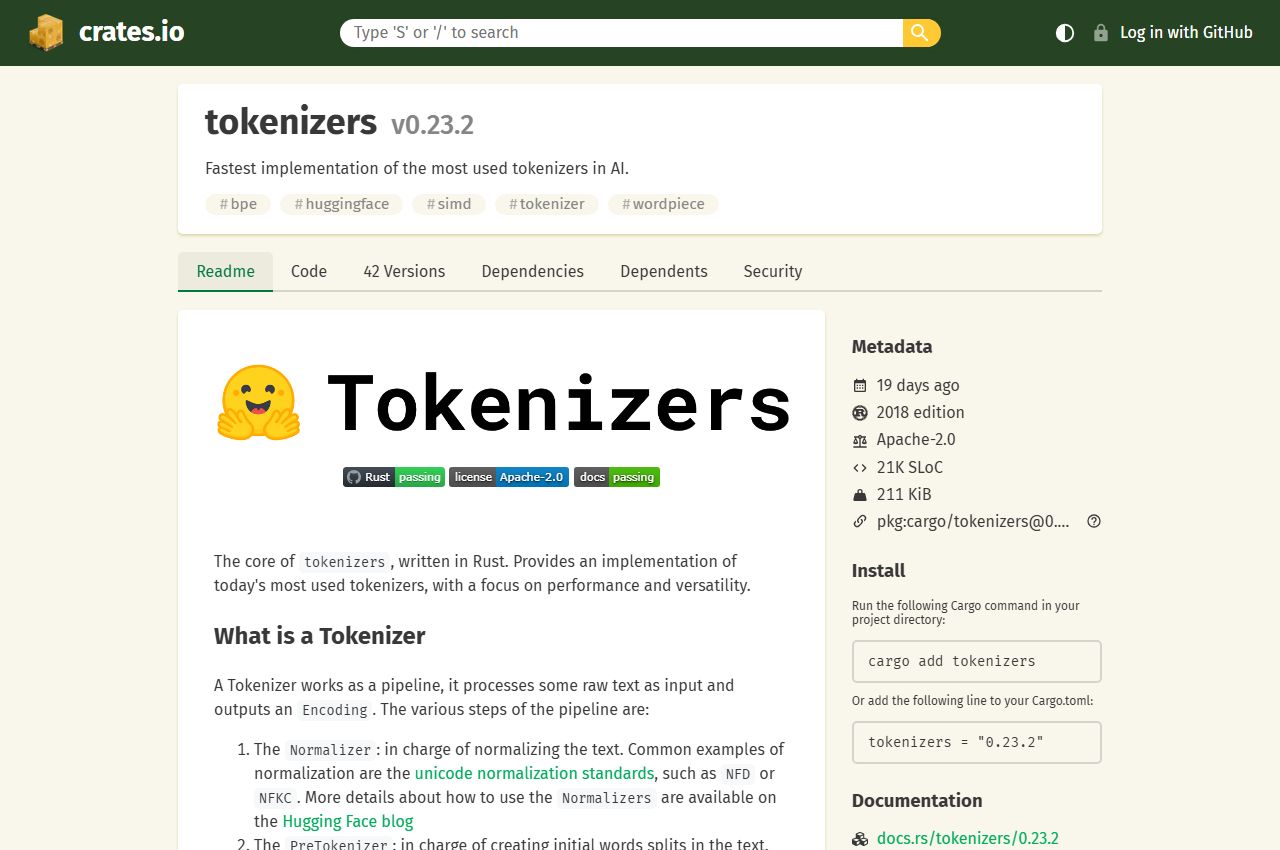
Tokenizer je první krok každého jazykového modelu: rozseká text na kusy, které model umí číst. Hugging Face svou knihovnu tokenizers přepsal a u kandidáta na verzi 1.0 naměřil třikrát až třicetkrát rychlejší kódování než u dnešní 0.23. Hotové vydání to ale není a čísla platí pro balík v Rustu, režie vazeb pro Python v nich není.