Kompresní knihovna OpenZL 0.3 rozbaluje podle měření Mety o 144 % rychleji než Zstandard
Meta vydala 29. září verzi 0.3 své kompresní knihovny OpenZL. Rozbalování zrychlil hlavně nový způsob ukládání Huffmanova kódu od Marcina Żukowského; při stejném kompresním poměru je podle autorů dvaapůlkrát rychlejší než Zstandard. U číselných dat nově vybírá kodeky malá neuronová síť.
Meta vydala 29. září verzi 0.3 knihovny OpenZL. Je to kompresní framework pod licencí BSD, který firma zveřejnila před rokem a který se od běžných kompresorů liší tím, že zná strukturu dat: tabulku čísel rozloží na sloupce a každý sloupec pošle přes jiný kodek. Podle poznámek k vydání přináší nová verze dvě hlavní věci – rychlejší vlastní engine LZ a takzvaný Compression Transformer, který kodeky pro číselná data vybírá neuronovou sítí.
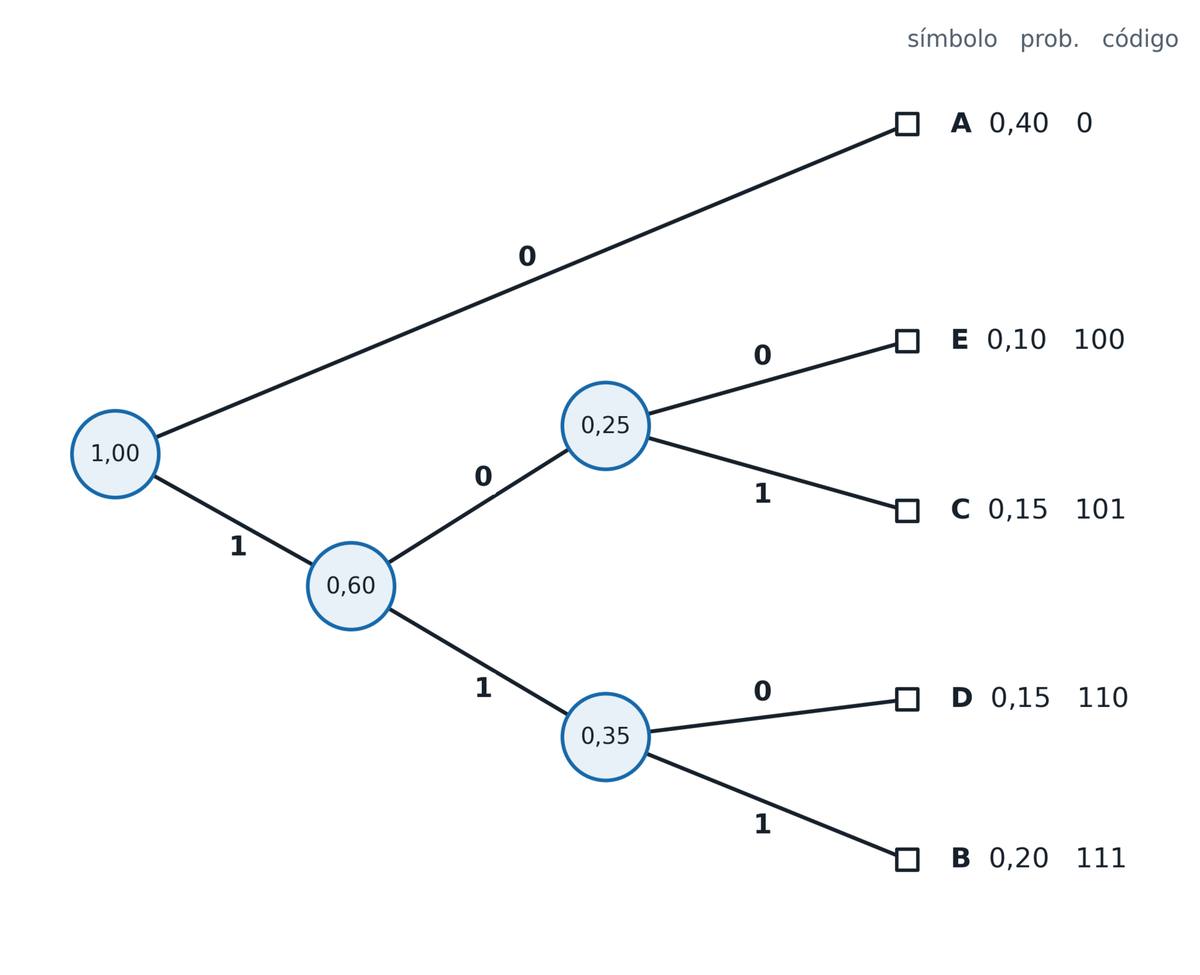
Stejný poměr, dvaapůlkrát rychlejší rozbalení
Vlastní engine LZ má OpenZL od verze 0.2.0 z května. LZ je rodina algoritmů, které opakovaný úsek dat nahradí odkazem dozadu na jeho dřívější výskyt; stojí na ní Zstandard, LZ4 i gzip. Autoři v poznámkách k vydání uvádějí srovnání na kompresní úrovni 1 s oknem 64 kB:
| kompresor | poměr | komprese | dekomprese |
|---|---|---|---|
| OpenZL LZ 0.3.0 | 2,73 | 467 MB/s | 3 062 MB/s |
| OpenZL LZ 0.2.0 | 2,74 | 466 MB/s | 2 288 MB/s |
| Zstandard | 2,74 | 419 MB/s | 1 254 MB/s |
Z tabulky plyne těch 144 %: 3 062 MB/s proti 1 254 MB/s je 2,44násobek. Proti předchozí verzi je rozbalování rychlejší o třetinu, komprese stojí na místě a poměr se o setinu zhoršil. Jsou to čísla autorů, nezávislé měření zatím nevyšlo. Zajímavé je, kdo je měřil: Zstandard vznikl ve Facebooku a Phoronix připomíná, že na něm dodnes pracují inženýři Mety. OpenZL tak porovnává s knihovnou téže firmy.
Engine zatím pokrývá obdobu úrovní 1 až 7 Zstandardu a okna do 256 MiB. Nick Terrell z týmu OpenZL v článku na blogu projektu přiznává, že na vyšších úrovních OpenZL komprimuje o něco hůř než Zstandard. Důvod je konkrétní: neumí takzvané opakované posuny, tedy levný zápis odkazu, který míří stejně daleko jako některý z nedávných. Doplnit je chtějí v dalších verzích, stejně jako slovníky pro malé soubory. Vedle toho má knihovna nastavení bez entropického kódování, která podle blogu rozbalují až o polovinu rychleji než LZ4.
Huffmanův kód se dekóduje po blocích, ne znak po znaku
Největší díl zrychlení přinesl nový dekodér Huffmanova kódu. Huffmanovo kódování přidělí častým znakům krátké bitové kódy a vzácným dlouhé, takže dekodér musí číst proud bitů jeden kód za druhým a každý krok závisí na předchozím. Podle Terrella připadala na Huffman v rozbalování LZ víc než polovina času procesoru a byl to poslední kodek, na který optimalizace ještě nesáhla.
OpenZL proto převzal PivCo Huffman, rozložení dat, které Marcin Żukowski popsal v práci na arXivu ze 4. června. Místo souvislého proudu kódů ukládá u každého vnitřního uzlu Huffmanova stromu bitovou mapu a dekodér pak data skládá odspodu nahoru, když podle mapy slučuje obě větve. Taková práce jde po celých blocích přes instrukce SIMD, které zpracují víc hodnot naráz. Proti dosavadní implementaci Huffmana v OpenZL je dekódování podle blogu dvakrát až třikrát rychlejší při podobné rychlosti komprese.
Druhou úpravu vymysleli v Metě sami a týká se posunů, tedy informace, jak daleko dozadu odkaz míří. Zstandard je rozkládá na mocninu dvojky a zbytek a mocninu kóduje entropicky. OpenZL posuny rozdělí do 16 nebo 32 přihrádek, jejichž hranice spočítá podle rozložení hodnot, a zapíše jen číslo přihrádky na čtyřech nebo pěti bitech a pozici v ní. Entropický kodek pak u posunů vůbec nepotřebuje. Dekódování posunů je tím dvakrát až třiapůlkrát rychlejší za cenu mírně horšího poměru.
Kodeky pro čísla vybírá malá neuronová síť
OpenZL skládá kompresi z grafu kodeků a najít pro daná data ten správný bylo dosud na uživateli, případně na trénování nad vzorky. Compression Transformer to dělá sám a pro každý vstup zvlášť: malá neuronová síť ohodnotí kandidátní kodeky pro jeden proud dat, vybere a výstupy pošle znovu stejnou smyčkou, dokud není graf hotový. Dekompresní strana se nemění, protože zvolený graf si komprimovaný soubor nese s sebou.
Autoři ho zkoušeli na 868 skupinách číselných dat, dohromady 34 737 souborech o 17,9 GB. Proti zstd -19 komprimoval v průměru o 35 % lépe a od grafů natrénovaných na konkrétní data zaostal o 1,1 %. Průměr ale skrývá velké rozdíly: u osmibitových čísel je zisk proti Zstandardu jen 1,3 %, u 64bitových 85 %. Transformer se zapíná až na úrovni 7 a výš, výchozí úroveň 6 zůstává beze změny.
Nové soubory starší verze nepřečte
Před přechodem stojí za přečtení konec poznámek k vydání. Nejvyšší verze formátu vzrostla z 24 na 27 a nové soubory ji používají automaticky, takže je OpenZL 0.2.0 nerozbalí; kdo potřebuje zpětnou čitelnost, musí nastavit ZL_CParam_formatVersion na 24. Uložené kompresory s grafem ZL_GRAPH_NUMERIC vyžadují verzi 0.3.0 a několik funkcí v API se přejmenovalo. Na procesorech ARM přibyly optimalizace pro NEON a SVE2 a spustitelné soubory zhubly zhruba o 447 KiB, protože z nich zmizel starší model pro číselná data.
Zdroje
- OpenZL v0.3.0 – poznámky k vydání na GitHubu (29. 9. 2026)
- Nick Terrell: LZ in OpenZL (blog projektu, 29. 9. 2026)
- Marcin Żukowski: PivCo-Huffman a práce na arXivu (4. 6. 2026)
- Phoronix: Meta Releases OpenZL 0.3 (29. 9. 2026)